外观
具身智能学习:Transformer
写在前面
我学习具身智能时,有一个卡点卡了很久:我说「把红色杯子拿起来」的时候,模型到底是怎么知道该去看桌上哪一块区域的?
这个问题听起来很朴素,但顺着它往下走,就能走到 Transformer 的核心。机器人的输入是几件完全不同性质的东西:摄像头给出的是几千个 patch,语言给出的是几十个 token,本体感受给出的是关节角度和末端位姿,再加上刚刚执行过的一串动作。分开处理它们并不难,难的是让它们互相知道对方的存在。
2017 年,Vaswani 等人在《Attention Is All You Need》里给出的答案,是把所有模态都摊成同一维度的向量序列,然后让每个位置自己去问其他位置:「你和我有关系吗?」[1] 我越往后学,越觉得这篇论文像一张技术地图,BERT、GPT、ViT、CLIP,以及现在的各类视觉语言动作模型,都能在上面找到熟悉的道路。
本文是我自己的学习笔记,不打算从零实现一个可训练的大模型。我想回答三个问题:为什么必须用注意力?一个 Transformer Block 里有哪些组件,各自负责什么?这套结构又是怎么接上视觉、语言和动作的统一建模的?
学习建议
本文是学习过程中的结构化笔记,不是零基础教程。我建立直觉主要靠沐神(李沐)的论文精读和 3Blue1Brown 的注意力机制动画,这篇文章更像是我把它们和公式对照一遍之后留下来的记录。
先记住四个词
Token 是模型处理的基本单位,文本可以按字、词或子词切成 token,图像可以切成 patch,连续动作也可以切成一小段一小段的动作 token。向量是一串数字,用来表示一个 token;维度就是这串数字的长度,例如 512 维表示由 512 个数字组成,后文的 hidden dimension 指的就是模型内部表示的维度。Batch 是一批同时送进模型的样本,模型会把它们放在一起计算。
机器人任务的信息关联问题
假设一台机器人站在桌子前,接到指令「把红色杯子拿起来」。这句话对人类来说没什么难度,对机器人却像一张小型考试卷。它至少要完成四步:
- 在图像中找到杯子、颜色和桌面的位置关系。
- 把语言指令里的「红色杯子」对应到图像里的具体物体。
- 结合机械臂当前的关节状态,规划下一步动作。
- 执行动作后重新观察环境,根据新状态继续控制。
如果机器人最后只回答「杯子在桌上」却没有伸手,说明它理解了问题,但没有把理解变成动作。
我最开始的误解是,把这件事想成「先看懂图,再听懂话」。按这个思路,视觉编码器和语言编码器各自做完自己的事,最后拼一下就行。但「红色」这个词究竟该对齐到图像里的哪一块?如果图已经压缩成了一个全局向量,这个问题就没法回答了:语言那一侧根本没有可以回头去问的对象。
所以我需要的不是更强的视觉模型或语言模型,而是一个能让所有位置互相查询的模块。
后来我发现这个理解是可以直接验证的,验证方式也是我排查多模态模型时最常用的一招:把某一层的注意力矩阵打印出来,横轴是视觉 patch,纵轴是文本 token,然后看「红色」这个词所在的那一行,权重是不是真的集中在杯子所在的 patch 上。如果整行几乎是平的,说明它压根没建立对齐,这时候再怎么调后面的动作头都是白费力气。这张矩阵比任何损失曲线都更能告诉我问题出在哪一层。
注意力机制的核心不是让模型「更聪明地看一眼」,而是让每个位置都能根据当前任务,从其他位置选择性地读取信息。
这也是 Transformer 适合具身智能的原因:不同模态都可以被编码成向量序列,再交给同一套「信息路由与特征变换」模块处理。注意力的价值不在于它多强,而在于它把这个路由过程从模型的先天结构里挪了出来,变成了可以按需学习的部分。
为什么需要注意力机制
RNN 的两个限制
在 Transformer 之前,序列到序列任务主要用 RNN、LSTM 或 GRU。它们沿时间顺序更新隐藏状态,很像一场只能单线程进行的接力赛:前一个时间步不把信息交出来,后一个时间步就不能开跑。
这种递归结构有两个直接问题:
- 训练难以并行:计算第 个状态必须先拿到第 个状态,GPU 没法像处理矩阵乘法那样同时算完所有时间步。
- 长距离信息要逐步传递:相距很远的两个 token 之间要经过很多次状态更新,早期信息容易被稀释,梯度也更难传播。
LSTM 的门控机制像是在接力棒上加了几个开关,能决定哪些信息留下、哪些丢掉。它确实缓解了遗忘,但没有改变递归计算的基本形式。
这里的「不能并行」我最初理解得太笼统了,才分清:RNN 并不是完全没法并行,batch 维度和特征维度照样能塞满 GPU,真正串行的只有时间那一个维度。问题是序列越长,这唯一一个串行维度就越长,GPU 的利用率会被它拖住。而注意力的所有位置本来就同时存在,连时间维度也不再有先后依赖。
把注意力变成主干
读到这里,我觉得 Transformer 的关键判断相当大胆:在这之前,注意力就已经用在编码器和解码器之间做信息对齐,只是它通常依附在 RNN 身上。既然真正负责「找关系」的是注意力,那干脆让它站到舞台中央,别只当 RNN 身边的助理。
对于长度为 的序列,任意两个位置可以通过一次注意力计算直接建立联系;训练时,整个序列还能批量转换成矩阵运算,把 GPU 喂饱。
代价也必须说清楚。标准自注意力要构造 的位置关系矩阵,计算和显存开销随序列长度呈二次增长。它是用更好的全局建模和并行能力,换来了长序列上的计算压力。对具身智能来说这笔账更明显:如果动作序列很长,注意力矩阵会先撑不住。
我还想替这份代价补一句它换来了什么。RNN 里两个相隔很远的位置,信息必须一步一步传过去,路径长度是 ;注意力把这条路径压到了 ——不管隔多远,都是一次查询的距离。梯度是从反向看这条路径的,路径短意味着它不容易在中间被稀释掉。这一点我觉得比「能并行」更本质,也是后来 Long Range Arena 那类长依赖任务上 Transformer 能赢的原因。
原始 Transformer 的组件分工
《Attention Is All You Need》的贡献不是提出了一条公式,而是把一组组件组合成了可扩展的架构:
- 用缩放点积注意力计算位置之间的相关性。
- 用多头注意力在多个表示子空间里并行建模关系。
- 用位置编码补充序列顺序。
- 用逐位置前馈网络提供非线性特征变换。
- 用残差连接和层归一化支持深层堆叠。
- 用因果掩码保证自回归解码时看不到未来 token。
后来的模型名字越来越多,但大多是在这张设计图上换配件、做取舍。
我自己回头排过这六条的「寿命」,结论挺有意思:位置编码、FFN、归一化这三样被换得最勤,几乎每一代模型都要动一次;而缩放点积、多头、残差几乎原封不动留到了今天。所以读一篇新论文时,我会直接跳到它对这三样的取舍,而不是从头顺着架构图往下看,效率高得多。
原始论文的配置
论文里的 Transformer 使用 6 层 Encoder 和 6 层 Decoder,,,注意力头数 ,每个头的维度是 64。现代模型的规模和具体组件变化很大,但基本的计算分工仍然相似。
整体架构
原始 Transformer 是一个 Encoder-Decoder 模型。Encoder 负责读题和整理资料,Decoder 根据这些资料写答案:Encoder 读源序列并生成上下文表示,Decoder 在已生成的目标前缀和 Encoder 输出的条件下,逐步生成目标序列。
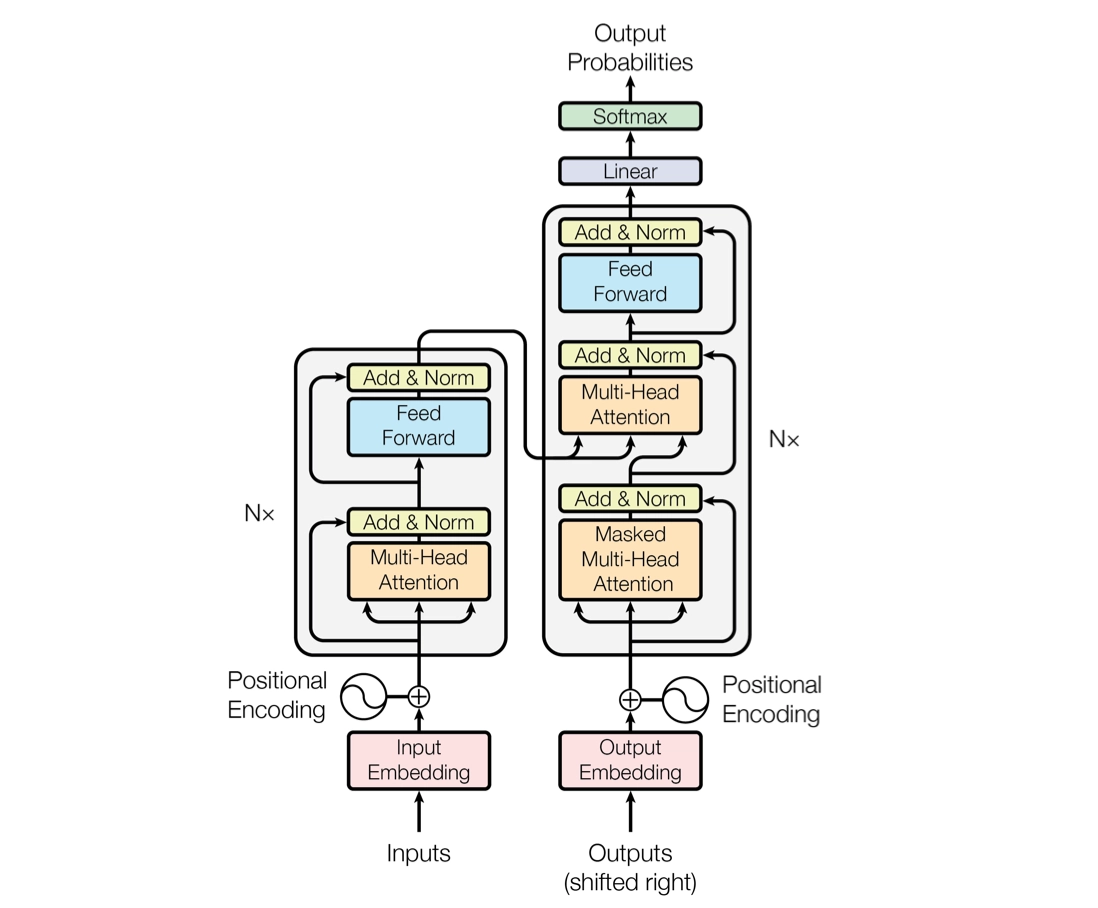
Encoder 的每一层包含两个子层:
- 多头自注意力,让不同位置交换信息。
- 前馈网络,对每个位置分别做非线性变换。
Decoder 的每一层包含三个子层:
- 因果自注意力,只读取当前及之前的目标 token。
- 交叉注意力,从 Encoder 输出里读源序列信息。
- 前馈网络,完成逐位置的特征变换。
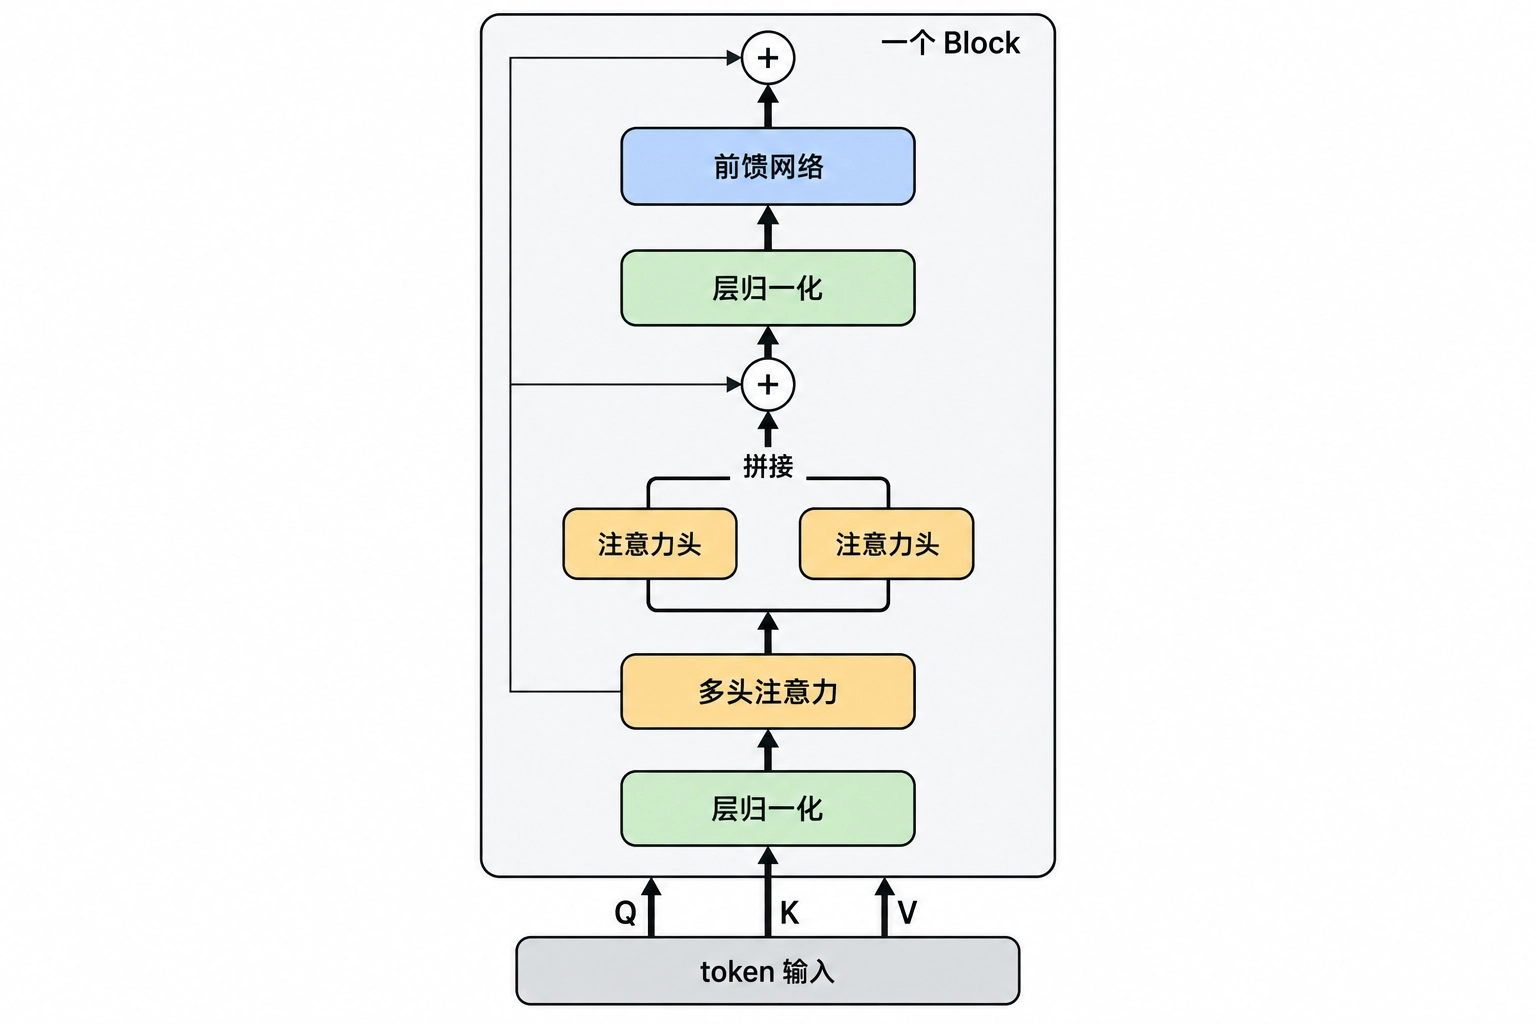
每个子层外面都套着残差连接和归一化。读结构图时,我会先把一个 Block 记成一句话:
先用 Attention 路由信息,再用 FFN 处理信息,最后用残差和归一化保证这条计算链能够稳定加深。
注意力机制
自注意力、因果自注意力与交叉注意力
这三种注意力经常被当成三件事,其实区别只在 Q、K、V 来自哪里。
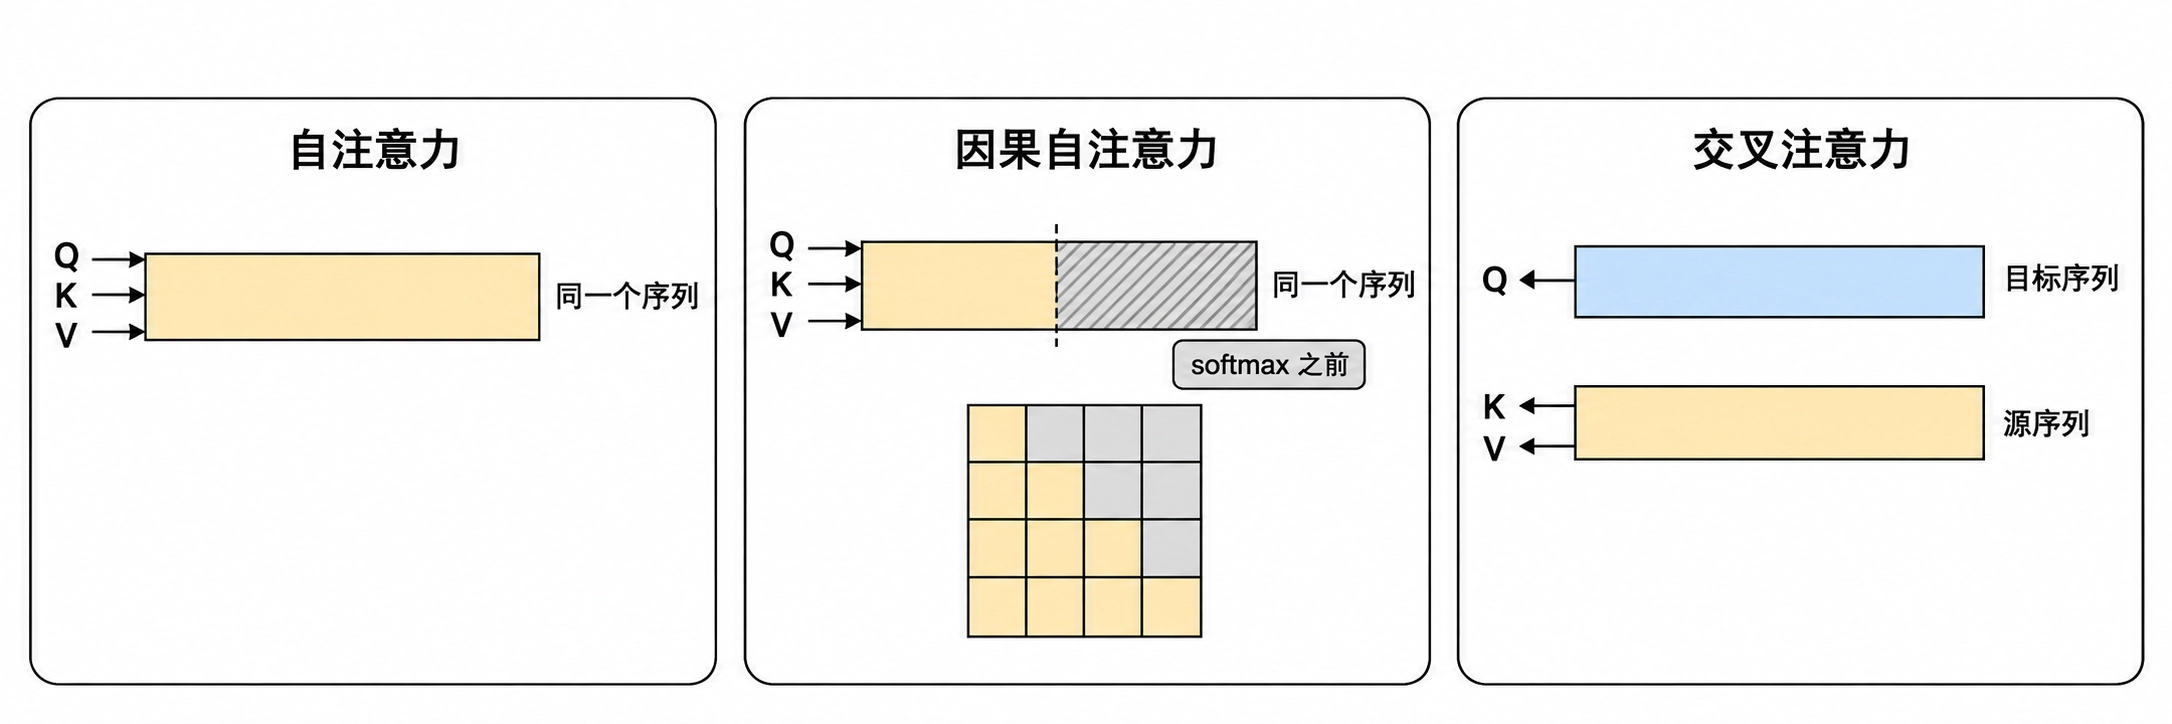
自注意力里,Q、K、V 全部来自同一个序列:
没有因果掩码时,每个位置都能读到整个序列。我把它理解成「同一组 token 互相开会」:每个 token 都可以向其他 token 提问,再根据答案更新自己的表示。
因果自注意力只多了一条硬规矩:生成第 个 token 时,不能看到第 个及之后的 token。掩码是一个下三角矩阵,1 表示可见,0 表示屏蔽:
| Query \ Key | pos1 | pos2 | pos3 | pos4 |
|---|---|---|---|---|
| pos1 | 1 | 0 | 0 | 0 |
| pos2 | 1 | 1 | 0 | 0 |
| pos3 | 1 | 1 | 1 | 0 |
| pos4 | 1 | 1 | 1 | 1 |
例如 pos2 可以读取 pos1 和自己,但看不到 pos3、pos4。实际计算时,被遮住的位置会被赋予一个极小的分数,经过 softmax 后权重几乎为 0。
具体填什么值会在不同的实现里飘:有人写 float('-inf'),有人写 -1e9,还有人用上三角布尔矩阵配合 masked_fill。我最初被这几种写法弄晕过,后来想通了它们其实等价——只要这个负数的绝对值和分数本身的量级差得足够远,softmax 出来就是 0。真正要小心的不是填哪个数,而是别在 softmax 之后才去乘 mask:那样分母已经被未屏蔽的位置算过了,权重加不到 1。另外 Padding Mask 和因果掩码是「与」的关系,两者形状不一样时要先广播对齐,这是我自己写崩过两次的地方。
交叉注意力的 Q 来自一个序列,K 和 V 来自另一个序列:
机器翻译里,Decoder 的目标 token 产生 Query,Encoder 的源语言表示提供 Key 和 Value。图像描述、扩散模型中的文本条件,以及多模态模型的模态融合,用的都是类似结构。它和自注意力的差别在于,提问的一方和提供资料的一方不是同一组 token。比如文本 token 可以向图像 token 提问:「图中哪个区域和我正在生成的词有关?」
这里有个工程上的差别我很晚才意识到。交叉注意力的 K、V 来自另一条序列,在整个生成过程里是固定不变的,所以它们算一次就能一直复用;自注意力的 K、V 每生成一个新 token 就多出一份,必须要 KV Cache 兜着。也就是说,多模态模型里图像那一侧的 Key、Value 本来就不需要重复计算,真正在涨的是文本侧自注意力的缓存——这也解释了为什么视觉 token 变多时,显存增长和纯文本长上下文不是同一种曲线,后来大家才会去做视觉 token 的压缩。
这里还有一个容易漏掉的细节:一个 batch 内序列长度通常不一样,要用 padding 补齐,Padding Mask 负责屏蔽这些无效位置。Decoder 需要同时套上因果掩码,只有既不是 padding、又没有违反因果顺序的位置才能参与计算。
padding 位置在注意力里被屏蔽了,但在算损失时还会再冒出来一次,所以这里要挡两道:一是注意力分数,二是损失函数(常见做法是给标签的 padding 位置填 -100 之类的忽略值,也就是 ignore_index)。我见过只挡了第一道的情况——注意力明明是干净的,loss 却一直偏高,查了半天才发现是模型在认真预测那些补齐用的空位。如果 padding 比例很大,模型学会的最省事策略就是「尽量预测 pad」,loss 曲线看起来照样在降。
缩放点积注意力
标准公式是:
其中:
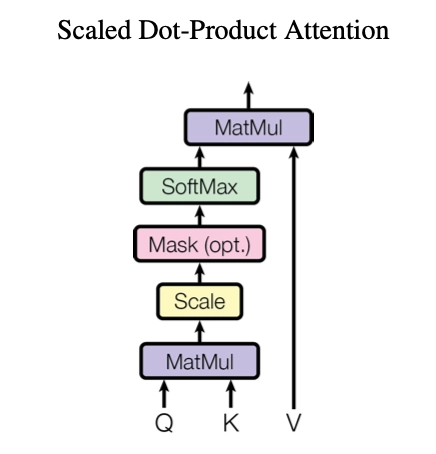
名字有点长,但把计算拆成四步就不容易迷路。它做的事就是先打分,再分配信息:
- 计算相关性得分 ,得到一个形状为 的矩阵。
- 除以 缩放分数,控制点积的数值范围。
- 对每一行做 softmax,得到每个 Query 对所有 Key 的注意力权重,权重总和为 1。
- 用这些权重对 Value 加权求和,得到形状为 的输出。
所以注意力的输出不是从某一个位置复制过来的,而是把多个位置的信息按比例混合起来。mask 的作用是在 softmax 之前把不允许读取的位置提前遮住。
除以 的理由值得单独记一下:维度增大时点积的方差会随之变大,softmax 容易过早饱和。一旦输出接近 one-hot,梯度就会变得很小,训练随之变难。
我第一次手写这段代码时把 Scale 漏掉了,前几十步 loss 看着还挺正常,之后就再也不动,梯度也没到爆的程度——这种「安静地卡死」比直接报错难查得多,因为函数上每一步都对,只是数值上已经掉进了饱和区。 的性质可以自己推一遍:假设 、 的每个分量都是均值 0、方差 1 的独立随机变量,那 的方差就是 ,除掉 正好把它拉回 1。也因此,很多实现里会把这一步和后面的 softmax 合并成一个 fused kernel,只为了少读写一遍那个 的中间矩阵。
计算瓶颈
标准注意力的主要开销来自 和 ,总体复杂度约为 。序列长度翻倍时,注意力矩阵相关的计算量大致变成原来的四倍。因此长上下文和长时序动作建模通常需要 FlashAttention、稀疏注意力或其他近似方法。
这里的二次增长具体有多大,可以拿数字量一下:序列长度 4096、单个头,那个 的分数矩阵在 float32 下大约就是 64 MB,再乘上头数和层数,显存会先于算力崩掉。FlashAttention 的思路就是不给这个矩阵落地,把 softmax 和加权求和拆成小块在片上算完[2]——它省的主要是显存读写,不是把 的计算量改掉。这一点我踩过坑:以为开了它就能无限拉长序列,结果算力该涨还是涨。
多头注意力
一个注意力头只能在一个投影子空间里学关系。但同一组 token 往往同时存在局部关系、句法关系、语义关系和长距离依赖。多头注意力让它们并行工作,再把结果融合:
其中:
通常令 。以 、 为例,每个头处理 64 维表示,8 个头拼接后重新映射回 512 维。
值得一提的是,这里的「分头」不是把句子切成 8 段,而是把每个 token 的特征切到 8 个不同的观察角度上:一个头可能更关心邻居,另一个头可能专门盯远处的指代关系。
不过这个「不同角度」的说法我只当成入门时的直觉,不再真的去给每个头派角色。我之前试过把某层注意力的 heatmap 拉出来,想找「负责指代的那个头」,翻了一遍发现大多数头的分布都很平,看不出干净的分工。后来看到有工作专门量化过这件事,结论是头的冗余度相当高——砍掉一部分对效果影响很小[3]。所以更准确的说法是:多头真正买到的是「多个随机投影里的多样性」,而不是一份可以逐个点名的岗位表。按这个理解,就不太会掉进「头数越多越好」的坑里。
多头注意力有时会被类比成 CNN 的多输出通道。这个类比只适合帮助理解「多个并行子空间」,不能当成同一种运算:CNN 通道提取的是局部空间模式,注意力头建模的是 token 之间的关系。
拆开一个 Transformer Block
注意力只解决了「不同位置如何交换信息」。但只会交换信息还不够,就像一个会议里所有人都能发言,不代表会议一定有结论。要构成可训练、可堆叠的 Transformer,还需要位置编码、FFN、残差连接和归一化。
位置编码
我记位置编码时用的说法是:注意力很会认人,却不太会看座位号。严格地说,自注意力对输入的排列是等变的,只改变 token 的排列而不加任何位置信息,它不会知道第一个 token 和第二个 token 谁在前。
原始 Transformer 使用固定的正弦和余弦编码:
不同维度使用不同频率:低维变化快,可以区分相邻位置;高维变化慢,可以表达更长范围的位置变化。实际使用时,可以把它理解成一张和 token 表示一样宽的「座位表」,每个位置都有一个向量,模型把它加到对应 token 上。原本只有「这个 token 是什么」的表示,就多了「它坐在第几个位置」的信息。
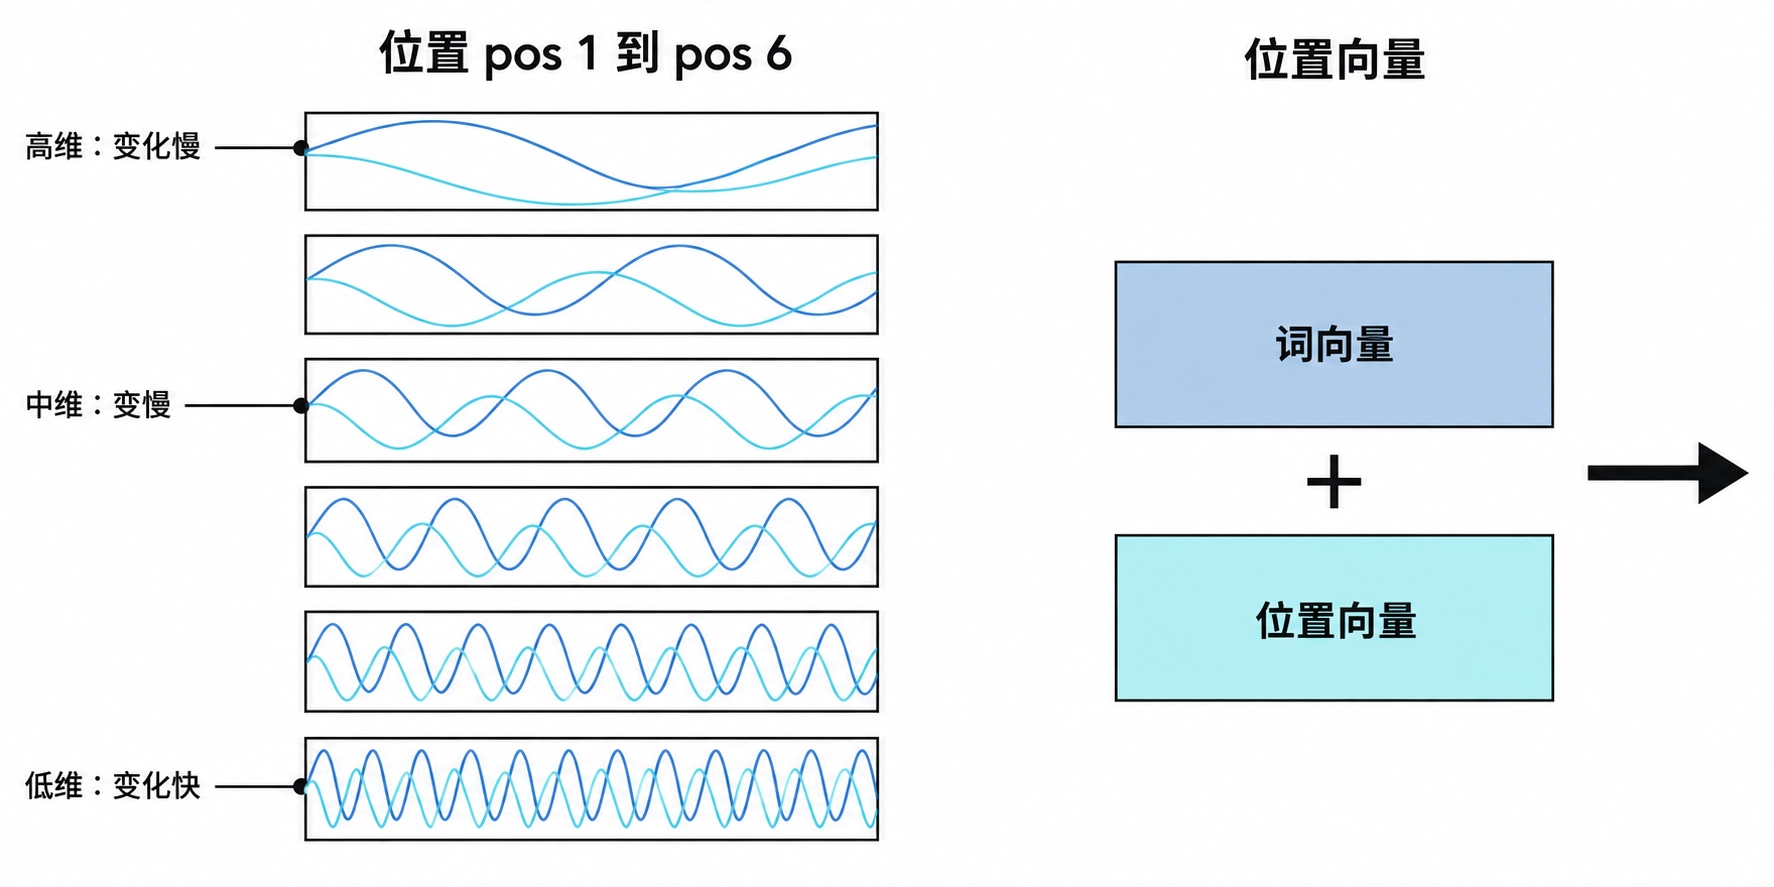
最初我有个想不通的地方:既然位置是「加」上去的,那它为什么还能被区分出来,而不是和词义糊在一起?关键是这些频率是成对的正弦、余弦,同一频率上任意位置的编码都能写成固定角度旋转的线性组合,所以「 处的编码加上 处的编码」可以换算成某种位置关系,模型要还原相对距离并不困难。也因为是直接相加,位置信号和词义共享同一批维度,这就埋下了后来 RoPE 要动它的原因。
后来常见的方案有几类:
| 方案 | 如何注入位置 | 优点与限制 | 代表模型或方法 |
|---|---|---|---|
| Sinusoidal PE | 将固定向量加到 token 表示上 | 无额外参数,外推能力有限 | 原始 Transformer |
| Learned PE | 为每个位置学习一个向量 | 简单,但通常受最大长度限制 | BERT、GPT-2 |
| RoPE | 旋转 Q、K,使点积包含相对位置信息 | 适合自回归模型,长上下文需要额外外推方法 | LLaMA、Qwen、Mistral |
| ALiBi | 直接给远距离位置的 score 加负偏置 | 不改 embedding,具有一定外推能力 | BLOOM |
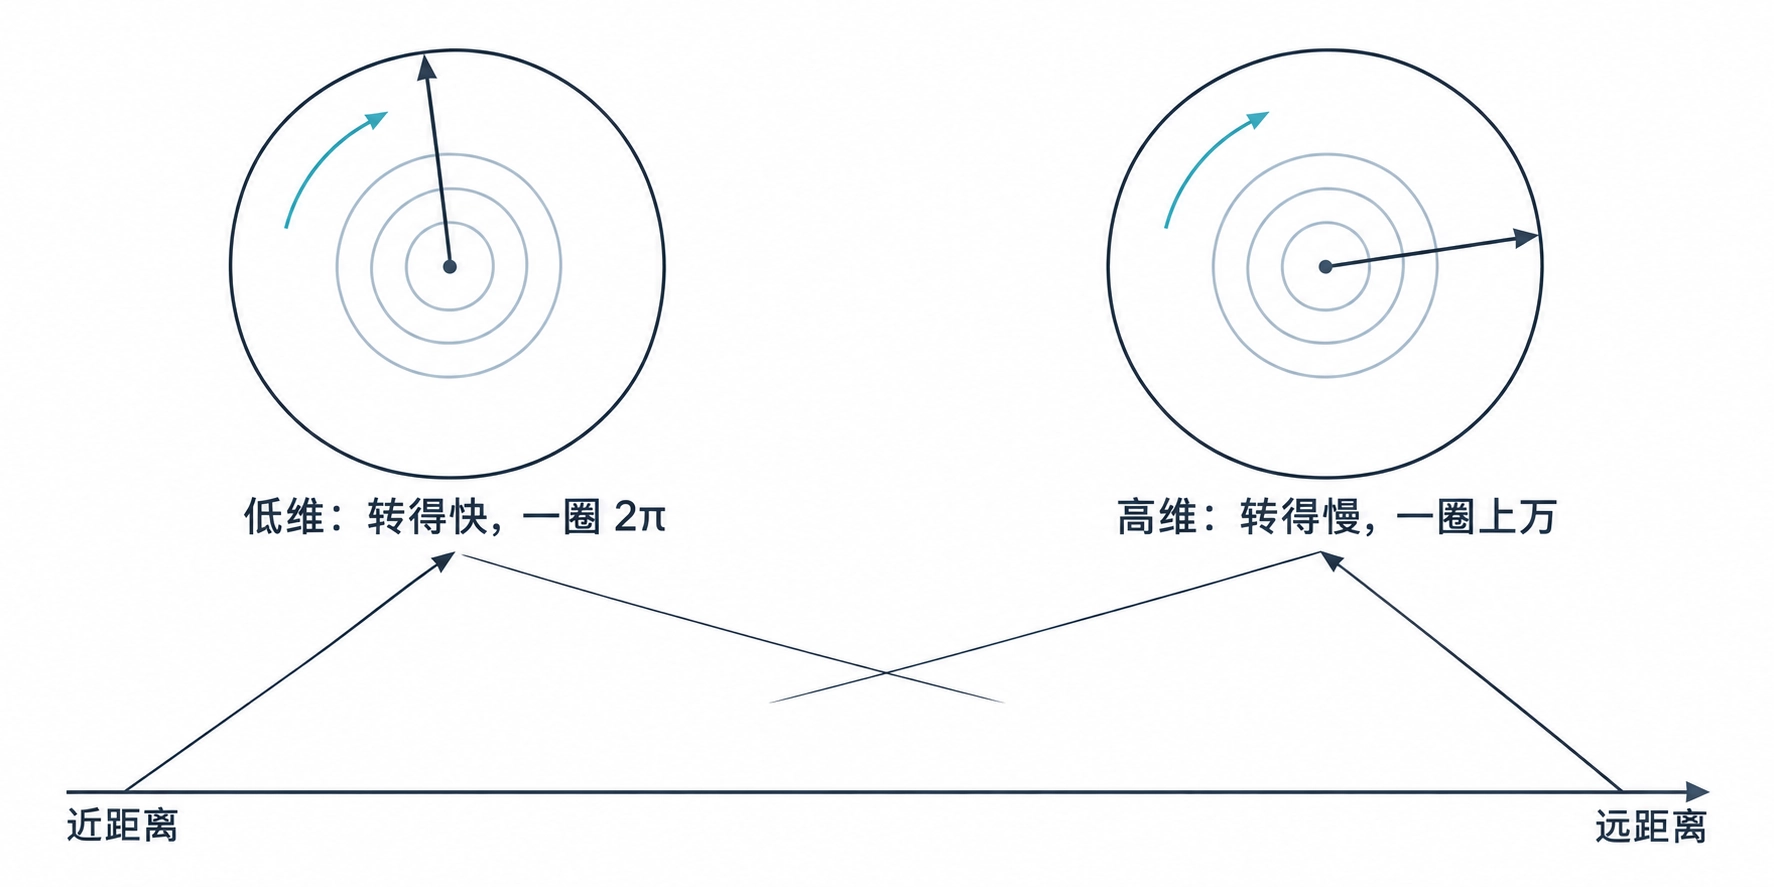
RoPE 的关键不是给输入加一个位置向量,而是在计算 Q 和 K 的点积之前按位置旋转它们。这样两个位置的相对距离会自然进入注意力分数:
这也是它在现代 Decoder-Only 模型里如此常见的原因。
这里有个具体的画面帮我记住了 RoPE 的性质:在 Q、K 的每一对维度上做一次旋转,最靠前的维度转得飞快,最靠后的维度转得极慢——一圈的周期从 一路拉到上万。所以近距离的先后靠快维区分,远距离的关系靠慢维兜住,构成了一套覆盖多个尺度的时间标尺。它不需要额外参数,也没有把位置和词义搅在同一个向量里,这是我理解它为什么能取代正弦编码的主要原因。
顺便一个查配置的习惯:模型支持的上下文长度并不在模型权重里,而写在配置文件的 max_position_embeddings 或 rope_scaling 字段上。想知道某个模型「原生能看多长」,翻这个文件比看宣传语准确。这里要提醒一句,rope_scaling 拉长的是位置索引的映射方式,不会让模型凭空多出处理更长序列的能力,超过训练长度太多时效果会掉。
前馈网络
注意力负责把信息送过来,但送过来之后还得加工,不能把一堆加权求和直接当成最终答案。每个位置都需要一个独立的非线性变换来组合和重编码这些信息,这就是 Position-wise FFN:
原始 Transformer 使用 ReLU,输入和输出维度都是 ,中间层通常扩大到 。同一组参数应用到每个 token,但不同 token 之间不发生直接计算。
于是两者的分工可以记成一句话:
Attention 负责「信息从哪里来」,FFN 负责「拿到信息后怎么变换」。
现代模型常用 GELU 或 SwiGLU。SwiGLU 使用门控分支:
其中 。为了让门控结构的参数量与普通 FFN 接近,实际模型会相应减小中间维度,常见取值约为 。
这里我曾长期把它当成「附属品」,直到看到参数量才改观:算一遍就知道,FFN 通常占了一个 Block 参数量的三分之二左右。不过参数多不等于算得多——注意力的计算量是 ,FFN 是 ,两者谁是大头完全取决于 和 的比例。序列短、模型宽的时候,瓶颈在 FFN;序列拉长之后,注意力那一项才会后来居上。这个比值是我判断「该先优化哪一块」时的第一个尺子。
残差连接
残差连接的直觉是:一个子层通常不会直接替换输入,而是学习一个增量:
这条残差路径给梯度提供了直接通道,也让子层只需要学「在已有表示上增加什么」。
我对「直接通道」的理解是:反向传播时,梯度沿着这条加法路径往回走,每经过一个残差分支,至少有一个系数是 1,而不是被一串雅可比矩阵连乘。所以深层网络里梯度不至于一路衰减到零,这也是能堆几十层的底气所在。顺着这个思路还能理解一件事:Transformer 的 Block 里,真正决定「这一层做什么」的是残差分支上的那个子层,主干更像是一条贯穿始终的传送带,这也解释了为什么把某一层整体剪掉,模型往往还能撑住。
层归一化
LayerNorm 我会想成检查每个 token 自己的行李有没有超重,而不是拿整趟列车的行李一起算平均。对于形状为 的输入,它在每个 token 的 hidden 维度内独立计算均值和方差,既不跨 batch,也不跨序列位置:
其中 和 是可学习参数, 表示逐元素相乘。
它和 BatchNorm 的差别可以放在一张表里:
| 方法 | 统计对象 | 是否依赖 batch size | 常见场景 |
|---|---|---|---|
| BatchNorm | 同一特征在不同样本之间的分布 | 是 | CNN |
| LayerNorm | 同一个 token 的 hidden 特征 | 否 | Transformer |
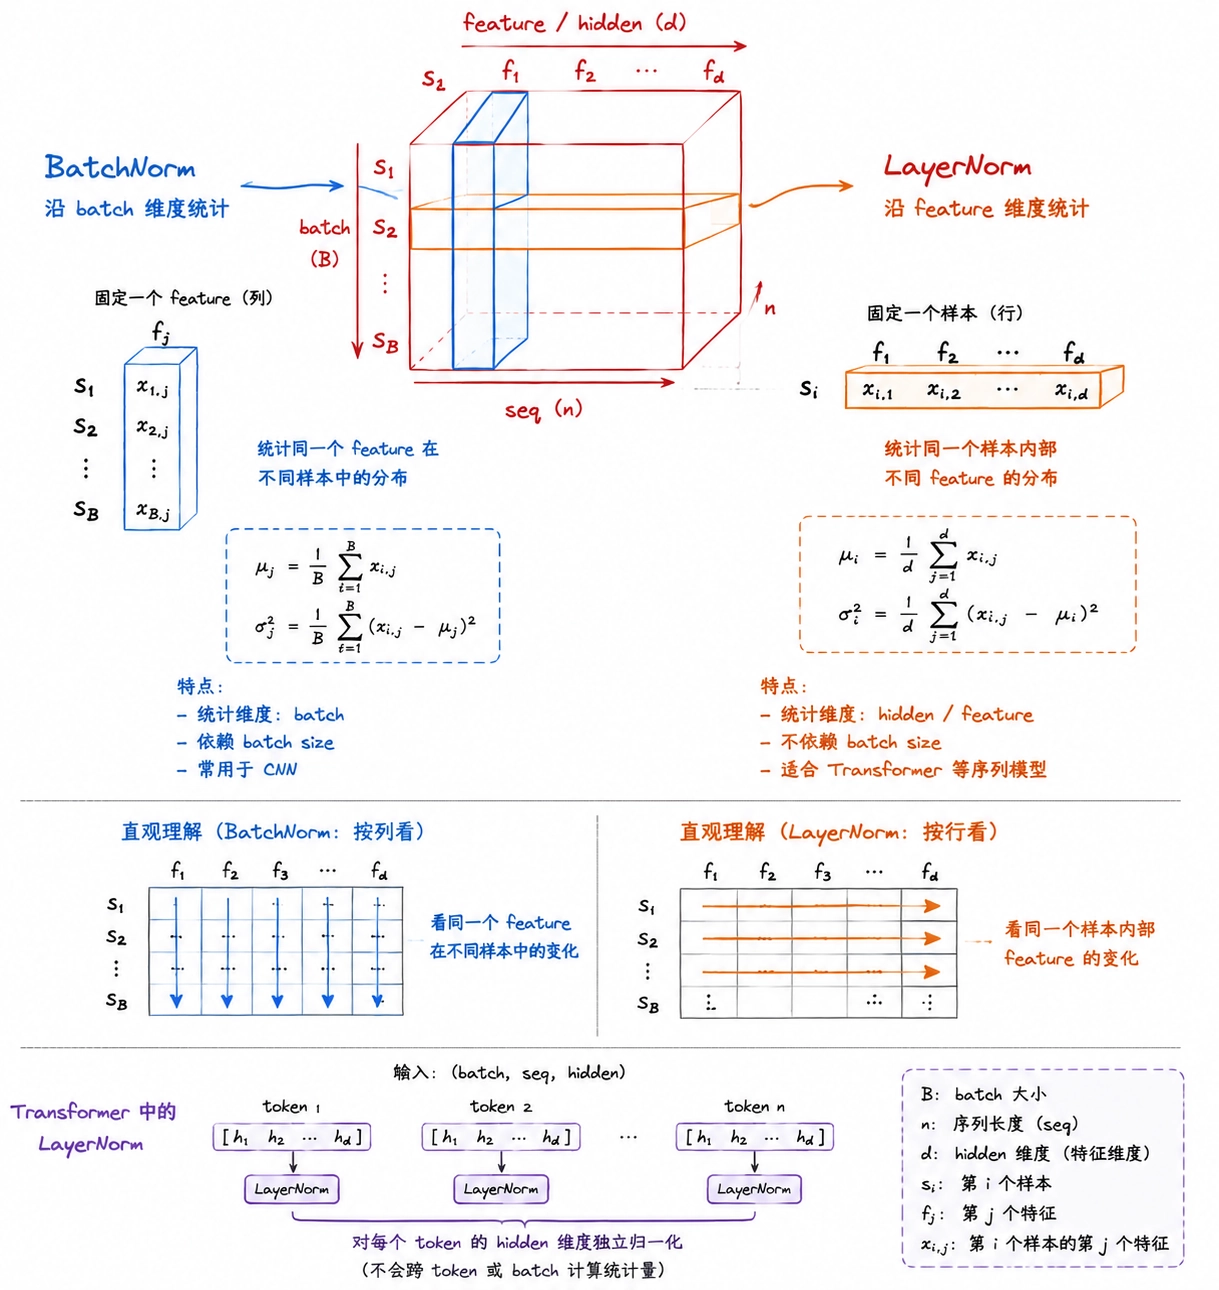
假设输入形状是 ,BatchNorm 沿 batch 维度看每一列,LayerNorm 沿 hidden 维度看每一行。这个区别解释了为什么 Transformer 在 batch size 很小、序列长度还在变化时,仍然能稳定使用 LayerNorm。
现代模型还经常用 RMSNorm:
它不减均值,只按均方根缩放,计算更简单。RMSNorm 不是「更正确」的 LayerNorm,而是大模型工程里常见的效率与稳定性取舍。
这件事一开始让我挺意外:减均值明明是归一化的核心动作,去掉它居然不怎么掉点,那减均值到底在干嘛。我后来的理解是,在 Transformer 里真正影响后续计算尺度的是特征的幅值,而中心化更多是让表示在原点附近有个稳定的参考。换句话说,均值和方差这两项里,起主要作用的是方差那一项。这也算是「大模型里的很多设计不是理论上最优,而是工程上够用」的一个例子。
归一化的位置也有讲究。原始 Transformer 用 Post-Norm,可以理解成「先改稿,再统一校对」:
现代大语言模型更常用 Pre-Norm,则是「先把稿纸整理好,再交给模块修改」:
Pre-Norm 的残差路径更直接,深层训练通常更稳定;Post-Norm 的最终表示可能有不同的尺度特性。具体怎么选,仍然取决于模型设计。
我当初以为这只是「把归一化挪个位置」的小事,后来才发现两者在训练上的差别很实在:Pre-Norm 的残差主干是纯加法,梯度能一路干净地传到底,所以堆深了也能顺着练下去;Post-Norm 的归一化卡在残差路径上,每层都会把尺度重新压一遍,层数一多就容易发散,早期要靠 warmup 和小心调初始化才压得住。这也是为什么现在几乎找不到还坚持 Post-Norm 的大模型。反过来看,Pre-Norm 的输出尺度会随着层数累积变大,所以很多实现会在最后接一个额外的归一化再送进输出头——这个「多出来的最后一个 Norm」经常是读代码时才注意到的细节。
三种架构与各自的训练目标
Encoder 和 Decoder 不是只能成对出现。按注意力掩码和训练目标划分,同一套零件有三种装法:
| 架构 | 注意力方式 | 训练目标 | 典型用途 | 代表模型 |
|---|---|---|---|---|
| Encoder-Only | 双向自注意力 | 掩码语言模型(MLM)或其他理解目标 | 分类、检索、特征提取 | BERT、ViT |
| Decoder-Only | 因果自注意力 | 因果语言模型(CLM),预测下一个 token | 文本生成、动作生成 | GPT、LLaMA、Qwen |
| Encoder-Decoder | Encoder 双向,Decoder 因果并交叉读取 Encoder | 序列到序列(Seq2Seq)目标 | 翻译、摘要、条件生成 | 原始 Transformer、T5 |
架构只规定信息如何流动,训练目标才决定模型被要求学会什么。模型不会因为看过一堆 token 就自动顿悟,它得先被布置作业。
因果语言模型给定前缀,预测下一个 token:
它使用因果掩码,GPT、LLaMA 和 Qwen 都属于这一范式。训练时通常把输入和标签错开一位:模型读到「我 喜欢」,要预测的标签是「喜欢 机器学习」。这样当前位置的输出对应的是下一个 token,而不是把当前 token 原样复述一遍;padding 位置会被标记为忽略,不参与损失计算。
「错开一位」这句话说起来简单,但它是我自己写训练循环时最容易错的地方,有个可以秒查的办法:拿一个极小的模型和两三条固定文本跑几个 epoch,看 loss 能不能压到接近 0。如果它就是卡在一个不低的平台上不动,多半是错位错了方向——预测成了当前 token 自己,模型等于在抄答案,看上去会学得飞快,实际上什么也没学到。所以在正式开训前,我会先做一次这种「能不能过拟合几条数据」的冒烟测试,比盯着 loss 曲线猜要省事。
掩码语言模型则随机遮住部分 token,让模型利用左右两侧的上下文恢复它们:
BERT 的经典策略是随机选取约 15% 的 token,其中 80% 替换为 [MASK],10% 替换为随机 token,10% 保持不变。这样做是为了减轻预训练阶段总有 [MASK]、而下游输入里没有 [MASK] 所造成的分布差异。
那个 80/10/10 的分配,我曾以为这纯粹是经验凑出来的,直到想明白它解决的是什么:如果 100% 都换成 [MASK],模型就只需要认识 [MASK] 这一个符号,而下游任务里这个符号压根不存在;留出 10% 换成随机 token,是在逼模型不能只看那个占位符,而要真的依赖上下文来判断;再留 10% 原样保留,则是因为这一路才是推理时的真实输入形态,也顺带避免模型学到「见到没见过的东西就丢掉」。这也解释了另一个我疑惑过的点:为什么 BERT 不能直接拿来生成——它的训练目标里从来没有「按顺序往下写」这件事。
顺着这个视角看,Encoder-Only 和 Decoder-Only 不是谁取代谁的关系,而是训练目标与使用场景不同:前者适合理解和表示学习,后者天然适合生成。至于具体到每一层里装了什么,不同代际的模型给出的答案并不一样:
这些变化主要对应三类工程目标:
- 训练稳定性:Pre-Norm、RMSNorm 和残差初始化帮助模型堆得更深。
- 推理效率:GQA 让多个 Query 头共享较少的 K/V 头,降低 KV Cache 的显存占用,代价是注意力头之间的独立性会少一些。
- 上下文处理:RoPE 把相对位置信息融进 Q/K 的关系计算,配合 YaRN、LongRoPE 等方法可以进一步扩展上下文长度。
顺便说一句「训练并行、生成串行」这个矛盾。训练时模型可以一次性并行算出所有位置,但每个位置只能读自己的前缀;推理时只能按 token 逐步生成。KV Cache 能复用已经算过的 Key 和 Value,减少生成阶段的重复计算,这也是推理侧的显存开销主要来自缓存、而不是参数的原因。
说到读模型,我后来学到一个比看结构图快得多的路子:直接翻 Hugging Face 上的 config.json。看 num_key_value_heads 是不是小于 num_attention_heads,就知道它用没用 GQA;看 rms_norm_eps 存不存在,就知道是 RMSNorm 还是 LayerNorm;rope_scaling 里有没有内容,能看出上下文扩展用了什么办法。这几行字段把前文那张对比表压缩成了几十个字符,读新模型时我基本都从这里入手,确认完再去翻它的技术报告。
把 Transformer 放回具身智能
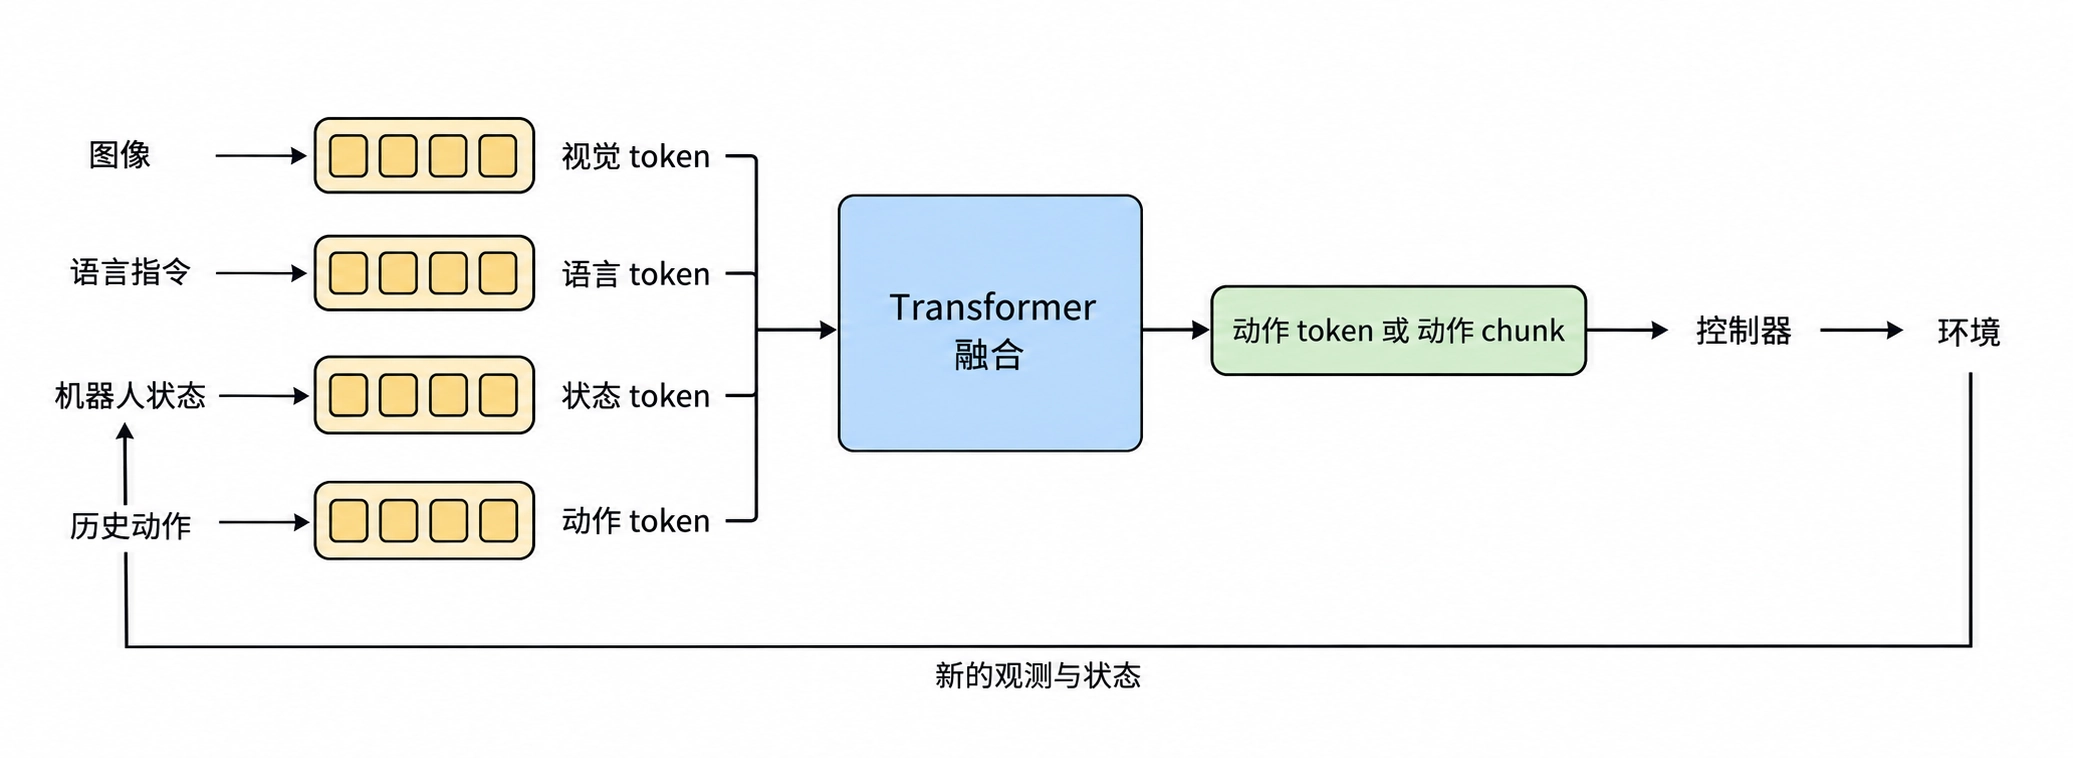
回到开头的机器人任务。要用 Transformer,第一步还是把各个模态转换成模型能处理的 token 或向量序列:
- 图像经过视觉编码器,得到 patch 或视觉 token。
- 语言指令经过 tokenizer 切成 token,再由 embedding 把每个 token 映射成向量。
- 关节角度、末端位姿、速度等状态被离散化或投影成状态 token。
- 历史动作按时间顺序编码,形成动作序列。
这些表示通过拼接、交叉注意力或专门的模态适配器交给 Transformer。一个常见的自回归 VLA 流程是:
编码观测
视觉编码器把图像转换为视觉 token,语言编码器或词嵌入把指令转换为文本 token,机器人状态投影到相同的隐藏维度。
融合上下文
Transformer 通过自注意力或交叉注意力,建立「指令—物体—状态—历史动作」之间的关系。
预测动作
Decoder-Only 模型使用因果注意力,根据当前上下文预测下一个动作 token 或一段动作 chunk。
执行并重新观察
控制器执行预测动作,机器人获得的新图像和状态加入下一轮上下文。
不过真把这条链跑起来,最先撞上的麻烦通常不是模型,而是各个模态的采样频率对不上:摄像头 30 Hz、关节状态 100 Hz 甚至更高,动作只有下发的那一刻才是新的。我一开始用「最近邻」硬对齐,结果发现机械臂在动作边界上会一顿一顿的,因为不同来源的数据被贴到了同一个时间片上,模型看到的是自相矛盾的观测。后来改用给每一个 token 单独加一个时间戳、把时间也当成位置信息的那一套,抖动才明显好转。这件事让我意识到,多模态融合难的地方一半在建模,另一半纯粹在数据对齐。
还有一个频率上的硬约束:如果控制环要求 100 Hz,而模型每生成一个 token 需要十几毫秒,那单靠自回归逐个 token 是追不上的。这也是动作 chunk——一次预测一小段动作再批量执行——会在这类系统里变得常见的原因:它把「生成频率」和「控制频率」解耦开,用时间换来了可行性。
这里必须留一条边界:Transformer 只提供信息建模能力,它不会因为学会了「把杯子拿起来」这句话,就自动懂得机械臂不能穿过桌面。动力学约束、碰撞检测、实时性和安全性仍然要交给控制器、规划器或安全过滤器。VLA 模型输出的是动作建议,能不能平安执行还要看后面的工程环节。
再对比两个任务会更清楚。在「看图问答」中,模型只需要从视觉 token 和问题 token 里生成文本答案;在「抓取杯子」中,它还要处理连续时间、执行反馈和动作误差。两者都可以用 Transformer,但数据形式、输出头和闭环控制方式并不相同。
我现在怎样看 Transformer
学到这里,我会把这条主线压成四句话:
- 注意力的价值在于让任意两个位置直接建立联系,把「信息怎么传来传去」从模型的先天结构里挪出来,交给按需路由。
- 一个 Block 的分工是先用注意力跨位置路由信息,再用 FFN 在每个位置上做变换;位置编码补顺序,残差和归一化保证能堆深,mask 决定什么能被看到。
- Encoder-Only、Decoder-Only、Encoder-Decoder 是同一组组件在「哪些位置允许互相看」和「拿什么目标去训练」上的三种答案。
- 对具身智能来说,Transformer 提供的是统一的信息交互框架,让视觉、语言、状态和动作能放进同一条计算链;数据采集、动作表示、控制器、环境反馈和安全约束,仍然要另行解决。
下次再看到 BERT、GPT、ViT 或某个 VLA 模型,我会先问几个具体的问题:输入怎么变成 token,Q、K、V 各自来自哪里,位置怎么处理,mask 挡住了谁,输出对着什么训练目标。能把这几个问题都答上来,结构图基本就读通了。
Transformer 不是魔法,也不是装上以后就会自己收拾桌子的万能大脑。但把「谁该看谁」这件事交给模型自己学,这一步确实把视觉、语言和动作放到了同一个平面上,后面那些模型才有条件往上长。
写到这里我也得承认,这篇文章里真正让我卡住过的地方,没有一处是公式——是「为什么必须除以 」这种不肯多想就会顺手抄过去的地方,是「mask 该在 softmax 之前还是之后」这种看公式看不出来、只能自己写错一次才知道的地方。公式把结果交给我,理解得靠我把每一步问一遍为什么。这也是我坚持把学习笔记写出来的原因:能顺着讲一遍,和能自己推一遍,中间差着很远。
Ashish Vaswani, Noam Shazeer, Niki Parmar, et al. Attention Is All You Need. NeurIPS, 2017. ↩︎
Tri Dao, Daniel Y. Fu, Stefano Ermon, et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS, 2022. ↩︎
Paul Michel, Omer Levy, Graham Neubig. Are Sixteen Heads Really Better than One? NeurIPS, 2019. ↩︎